Données non structurées : comment les exploiter en PME ?
Publié le 11 septembre 2026 · Solanys
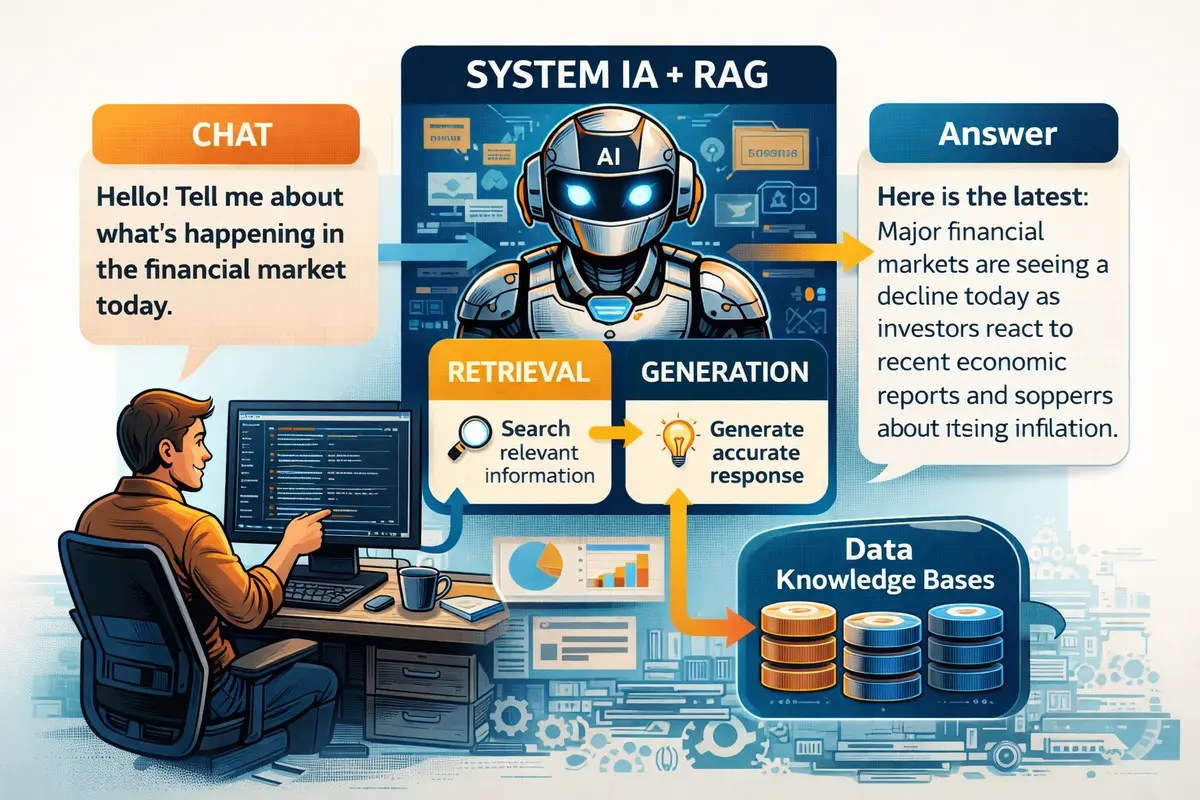
Les données non structurées sont les informations qui ne se présentent pas directement sous forme de champs prêts à être utilisés : texte d’un email, compte rendu d’intervention, photographie ou documentation technique. Pour une PME, les exploiter commence par une décision concrète : faut-il retrouver une réponse, alimenter un logiciel ou mesurer une tendance ? Ces objectifs demandent des traitements différents.
Données structurées, semi-structurées et non structurées
Une table de commandes avec des colonnes définies est structurée. Un ensemble de messages dont le contenu varie ne suit pas le même schéma métier. Entre les deux, un fichier avec des clés ou des balises peut être semi-structuré. La présentation des données non structurées par IBM situe notamment les documents, emails et contenus multimédias dans cette famille.
| Catégorie | Exemple | Ce qui reste à vérifier |
|---|---|---|
| Structurée | Table ERP : client, référence, quantité | Qualité des valeurs et sens des champs |
| Semi-structurée | Événements JSON avec attributs variables | Clés disponibles, types et champs manquants |
| Non structurée | Commentaire libre dans un rapport | Contexte, interprétation et informations implicites |
| Mixte | Email avec expéditeur, date et corps libre | Distinction entre métadonnées et contenu |
La distinction ne dépend pas uniquement de l’extension du fichier. Un tableur peut contenir des commentaires libres ; un PDF peut inclure des tableaux ou un formulaire. Examinez le contenu et ce que vous souhaitez en tirer avant de choisir un outil.
Trois façons d’exploiter les données non structurées avec l’IA
1. Extraire des champs pour alimenter un outil métier
Vous souhaitez transformer une demande reçue par email en fiche exploitable : produit, quantité, date demandée et client. Il faut définir les champs attendus, extraire les valeurs puis les contrôler. Une information absente doit rester absente ou être demandée à une personne. Notre guide sur l’automatisation de la saisie de données couvre ce parcours jusqu’au logiciel cible.
2. Rechercher des passages pour répondre à une question
Vous voulez retrouver une consigne dans vos procédures. Le résultat attendu est une réponse accompagnée de passages vérifiables, pas nécessairement un tableau. Une base de connaissances IA organise les sources, leurs versions et leurs accès. Conserver le contexte évite qu’une exception soit séparée de la règle qu’elle précise.
3. Classer des contenus pour analyser une tendance
Vous cherchez à comprendre les motifs de réclamation ou les incidents les plus fréquents. Définissez des catégories, faites annoter des exemples par l’équipe métier puis comparez les propositions du système aux annotations. Une synthèse rédigée ne remplace pas un comptage vérifiable : chaque catégorie doit pouvoir être reliée aux dossiers qui la composent.
Exemple : analyser des comptes rendus de maintenance
Imaginons un atelier qui conserve des comptes rendus en PDF et des commentaires libres dans un logiciel. Cet exemple est fictif ; il illustre une méthode sans revendiquer de gain client mesuré. La question métier est : « Quels incidents reviennent sur cette famille de machines ? »
- Délimiter : sélectionner une période, une famille de machines et des sources identifiées.
- Rapprocher : associer chaque rapport à un identifiant d’intervention pour éviter de compter plusieurs copies.
- Lire : récupérer le texte, en ajoutant un OCR pour les scans qui le nécessitent.
- Extraire : relever machine, date et symptôme en conservant le passage source.
- Classer : attribuer un motif parmi des catégories définies, avec une catégorie « indéterminé ».
- Valider : faire relire les cas ambigus et les résultats d’un échantillon de contrôle.
- Compter : agréger les interventions uniques par motif et afficher les dossiers non classés.
Il faut distinguer symptôme, cause supposée et cause confirmée. La mention « vérifier le capteur » ne prouve pas une défaillance du capteur. De même, une hausse des rapports peut refléter une meilleure collecte plutôt qu’une hausse des pannes. Sans données sur l’utilisation des machines, le nombre d’incidents ne donne pas à lui seul un taux de panne comparable.
Inventorier les sources avant de construire le traitement
Pour chaque corpus, renseignez son propriétaire, son emplacement, son format, sa période de couverture et les équipes autorisées à le consulter. Vérifiez si les archives sont complètes et si les fichiers récents suivent la même présentation que les anciens.
- Versions : identifier les documents remplacés et les brouillons.
- Qualité : repérer les scans illisibles, tableaux tronqués et pièces jointes absentes.
- Identifiants : relier le contenu au client, produit ou dossier concerné.
- Contexte : conserver titres, unités, dates et passages justificatifs.
- Accès : appliquer les droits avant de transmettre du contenu au modèle.
Pour la lecture des pièces jointes, notre guide sur l’extraction automatique des données PDF détaille les difficultés de mise en page. Les documents récupérés doivent rester des données à interpréter : une instruction écrite dans leur contenu ne doit pas modifier les permissions du système.
Évaluer les résultats selon l’usage
Constituez un jeu de référence avec des exemples courants, des cas rares et des données manquantes. Gardez une partie des dossiers pour une évaluation finale indépendante du réglage initial. L’équipe métier doit définir ce qui constitue une erreur acceptable ou bloquante.
| Objectif | Mesure utile | Erreur à rechercher |
|---|---|---|
| Extraction | Exactitude par champ et temps de correction | Valeur plausible mais absente du document |
| Recherche | Source pertinente retrouvée et réponse justifiée | Procédure périmée ou inaccessible à l’utilisateur |
| Classification | Erreurs par catégorie et dossiers non classés | Catégorie fréquente masquant les cas rares |
| Analyse | Comptages reproductibles à partir des dossiers | Doublons ou population incomplète |
Mesurez aussi le délai pour obtenir un résultat validé et le coût de supervision. Un traitement rapide qui demande une relecture complète n’apporte pas le même bénéfice qu’un traitement dont seules les exceptions sont examinées.
Quel premier projet lancer dans votre PME ?
Choisissez une question récurrente, un corpus accessible et un responsable disponible. Fixez un livrable observable : un tableau de champs vérifiés, une recherche sourcée ou un classement contrôlé. Évitez de commencer par réunir toutes les archives sans usage défini.
Le budget dépend notamment des connecteurs, du nettoyage, de la diversité des formats, des permissions et de la validation. Le nombre de fichiers ne suffit donc pas à l’estimer. Prévoyez aussi les mises à jour et le retrait des documents supprimés ou devenus obsolètes.
Solanys accompagne les PME pour analyser et exploiter leurs données métier et mettre en place des solutions d’IA documentaire. Préparez quelques exemples anonymisés et la décision que vous souhaitez améliorer : ils permettront de choisir un premier périmètre utile.